一、背景 & 场景
1.1 环境
设备型号:Android arm64 真机、已刷 APatch / KernelPatch
内核模块:khwbp.kpm
手机端控制器:khwbpctl
分析工具:IDA Pro、adb、dmesg、APatch supercall
1.2 引言
Android 逆向里,hook 也是绕不开的基本功。常见方案——Frida、Dobby、xhook、inline trampoline——大多数时候很好用,但碰到风控 SDK / 加固壳 / 反调试组合拳,就开始变得吵:
- inline hook 改了目标函数开头几条指令,
__text校验一跑就露馅; - Frida / gadget / gum-js-loop 这类特征太显眼,很多 SDK 已经按套餐扫;
mprotect + RWX、可疑匿名可执行页、跳板区、PLT/GOT 改写,都能被归到“环境异常”;- 部分目标会扫线程、端口、maps、符号、指令序言,甚至在关键函数前后自检。
有没有办法不碰目标函数一字节代码,只靠 CPU 自己的地址比较器来“截住”执行?有,答案就是 ARM64 硬件断点。
Android 用户态不能直接写 EL1 Debug 寄存器,常规 ptrace/perf 路径又太显眼。要做得稳,最直接的路是进内核:用 APatch / KernelPatch 的 KPM,在内核侧写 DBGBVR/DBGBCR,hook do_debug_exception,命中后记录寄存器、读参数内存,甚至在异常返回前直接改目标进程数据。
本文记录的就是这套 khwbp:一个基于 APatch KPM 的 Android arm64 硬件断点 hook 小引擎。它支持按包名 + SO 文件偏移下断、App 重启后自动重挂、打印入口参数/返回值/指针内存,以及命中后自动写数据。文中目标 App、路径、指纹、密钥、明文等均做脱敏处理。
1.3 对抗场景:安全 SDK 的 hook 检测
这次动机同样来自实战。目标 App 内置商业安全 SDK,native 层有设备信息采集、签名、加密、环境检测等逻辑。直接 Frida stalk 或 inline hook,有几个明显问题:
- 函数头改写会被扫:关键 native 函数入口如果变成
B xxx、LDR/BR跳板,非常容易被发现; - maps 特征明显:Frida、gadget、匿名可执行页、注入 so 都是高频检测项;
- 代码段完整性校验:SDK 对自己的 so 做 CRC / hash,任何 patch 都可能导致结果不可信;
- ptrace / perf / uprobes 等外部调试面:容易和反调试逻辑撞车。
硬件断点的优势在这里很直接:
目标指令不变、函数头不变、method 表不变、GOT/PLT 不变;命中靠 CPU Debug 寄存器比较,异常由内核消费。检测面从“代码被改/进程被注入”收敛到“Debug 寄存器被设置”和“内核异常路径被接管”。
1.4 研究动机与目标
- 搞清楚 Android arm64 上硬件断点从
DBG*寄存器到do_debug_exception的完整路径; - 用 APatch KPM 做一套内核侧无痕 hook,不改目标 App 代码;
- 支持真实逆向中最常用的工作流:按包名、按 SO 偏移、App 重启自动重挂;
- 在真实加固 App 上验证参数、返回值、内存预览、命中后改数据是否可用。
二、硬件断点原理
2.1 三层机制
Android arm64 上的硬件断点,本质也是 ARMv8 Debug 架构 + Linux debug exception + KPM 接管异常处理。可以拆成三层:
① 底层:ARM64 Debug 寄存器
硬件断点不是 BRK,也不是改函数头,而是 CPU 里专门的比较器:
- 指令断点:
DBGBVR<n>_EL1(地址)+DBGBCR<n>_EL1(控制) - 数据观察点:
DBGWVR<n>_EL1+DBGWCR<n>_EL1 - 数量由
ID_AA64DFR0_EL1报告,实测设备常见是 6 个指令断点 + 4 个观察点
DBGBCR/DBGWCR 的几个关键位:
| 位 | 名称 | 含义 |
|---|---|---|
| bit0 | E | 使能 |
| bits[2:1] | PMC/PAC | 匹配 EL0 用户态访问 |
| bits[12:5] | BAS | Byte Address Select,选择命中字节 |
| bits[4:3] | LSC | watchpoint 读/写/读写匹配 |
② 内核层:EL0 不能直接写 Debug 寄存器
App 在 EL0,没有权限执行 MSR DBGBVR0_EL1, x0。常规调试器靠内核的 perf/hw_breakpoint 或 ptrace 间接设置,但这些路径都太“正规”,也更容易被观察到。
khwbp 选择绕过 perf 框架:KPM 运行在内核侧,直接用 mrs/msr 写 DBGBVR/DBGBCR/DBGWVR/DBGWCR。Debug 寄存器是 per-CPU 的,所以 slot 表更新后用 on_each_cpu() 同步到每个 CPU。
③ 异常分发:hook do_debug_exception
当 EL0 执行到被下断地址,CPU 产生同步 Debug 异常,Linux/Android 内核进入 do_debug_exception。如果这是 perf/ptrace 认识的事件,内核会按正常调试流程处理;但我们直接写寄存器,原 handler 并不知道这些断点是谁的。
所以 KPM 必须 hook do_debug_exception:
- 如果 PC/FAR 命中
khwbp的 slot,就记录现场并消费异常; - 如果不是我们的事件,就放回原 handler;
- 消费后还要负责“踏过断点”,否则异常返回会立刻再次命中,目标线程原地打转。
2.2 为什么叫”无痕”
- 目标代码段不改:不写
B跳板,不破坏函数序言,过大多数__texthash; - 不依赖 Frida / inline trampoline:没有 gadget、gum、匿名跳板区等典型特征;
- 按 pid/包名过滤:同一个 so 偏移只作用于目标进程;
- 命中后可直接读/改寄存器现场对应的数据:入口参数、返回值、结构体字段都能在不插桩的情况下观察。
代价也明确:硬件槽位很少,异常处理写错会把目标线程卡死,内核态代码一旦出错就是重启级别的反馈。
三、引擎实现
整体流程分成控制期和命中期。控制期由 khwbpctl 解析包名、pid、SO 文件偏移,再通过 APatch supercall 把命令送进 KPM;命中期由 KPM 在 debug exception 里记录现场、执行 patch、恢复断点。
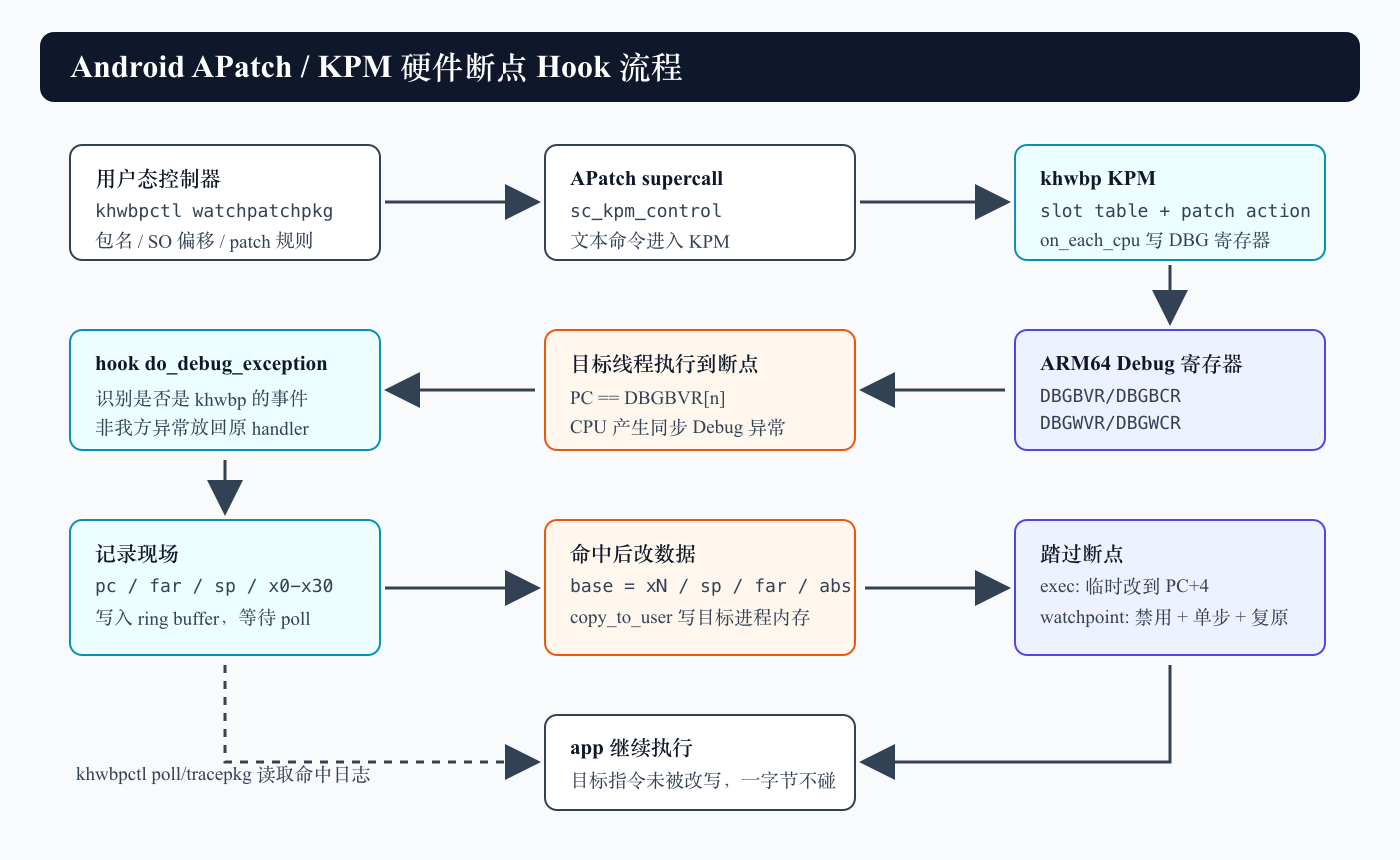
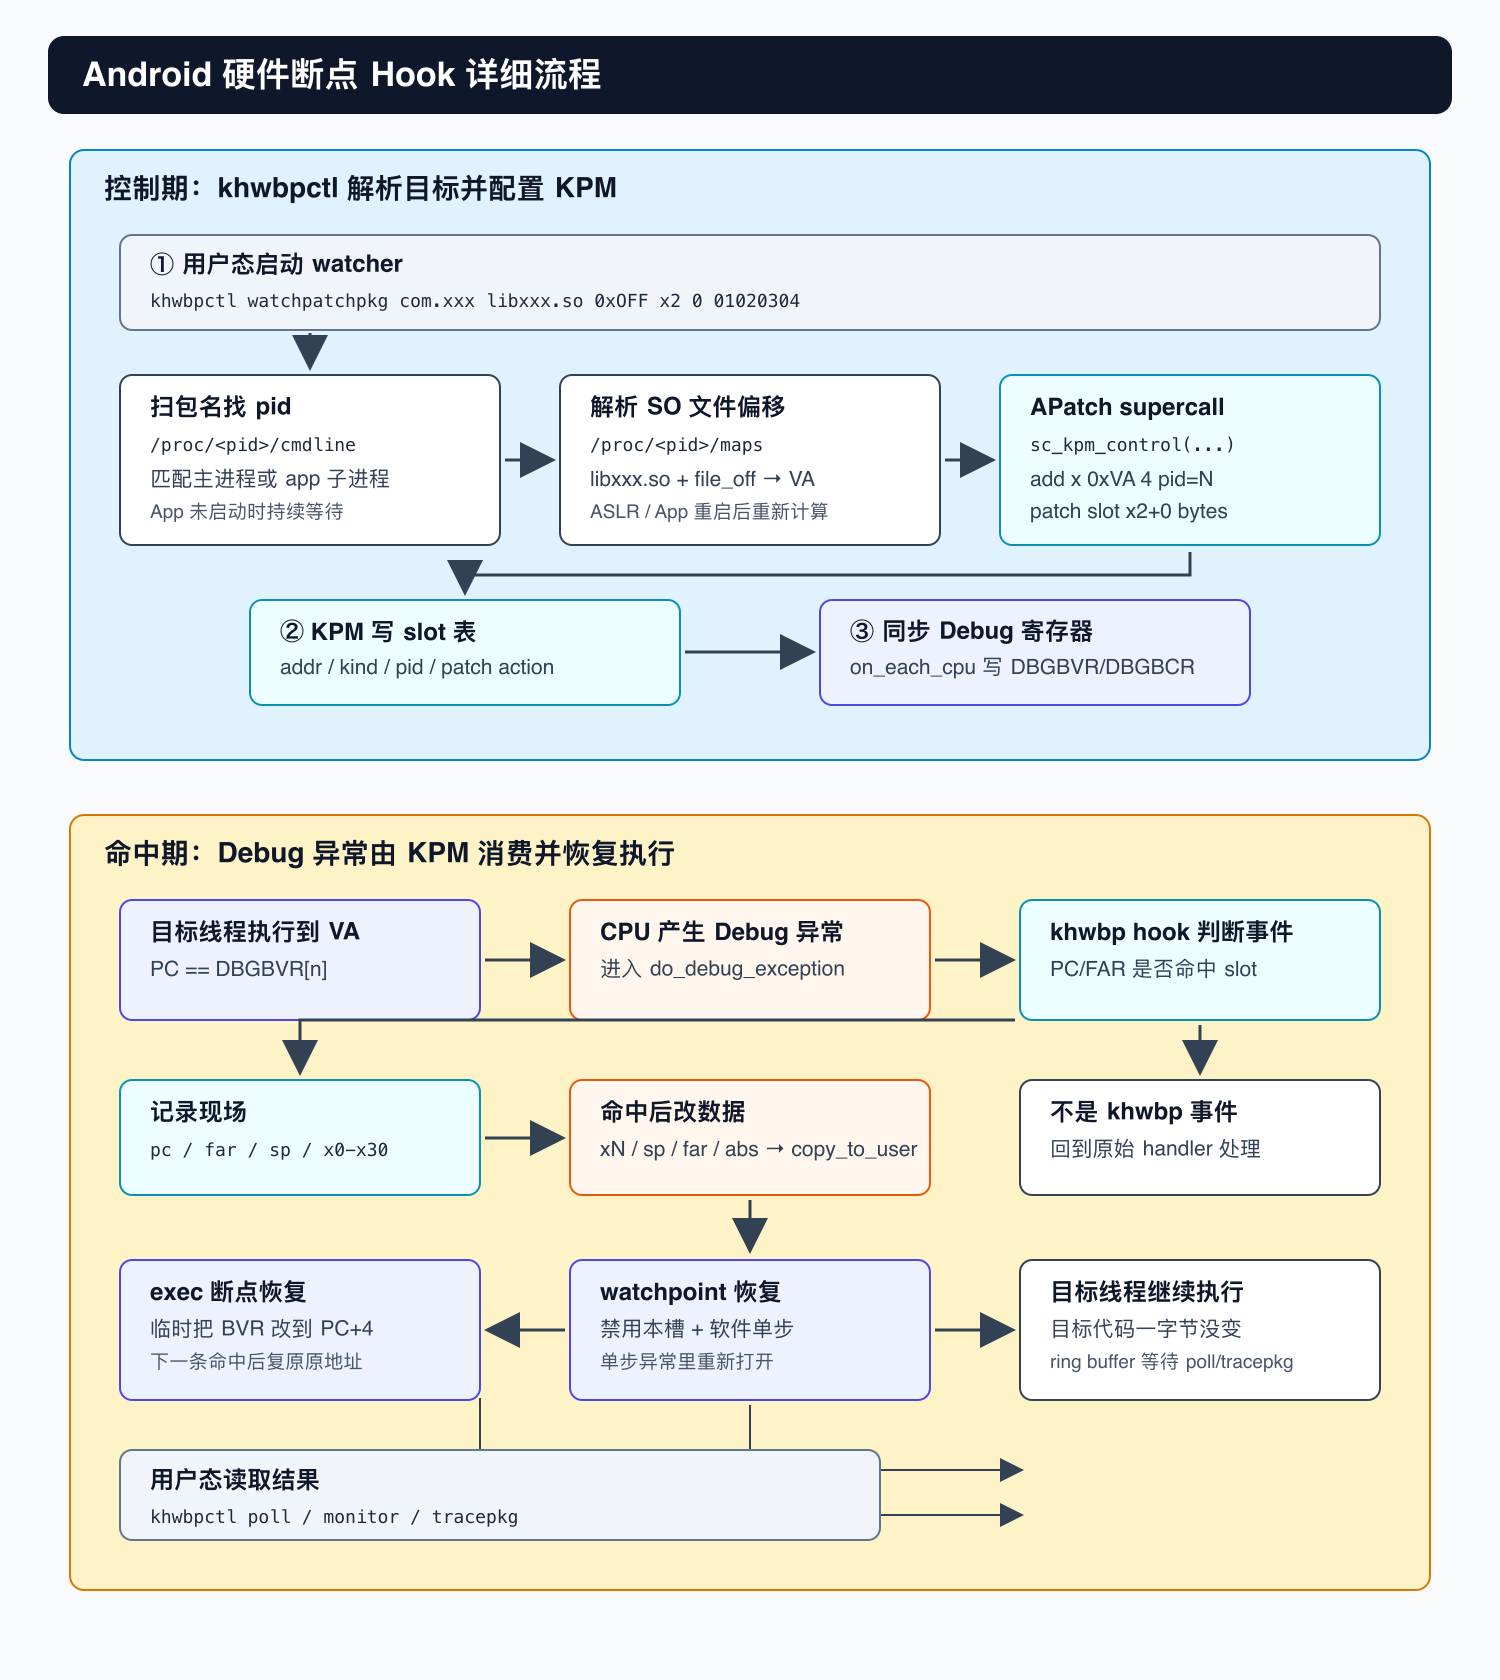
3.1 下断点
KPM 初始化时先探测硬件槽位数量:
static inline u32 khwbp_num_brps(void) {
    u64 dfr0;
    asm volatile("mrs %0, id_aa64dfr0_el1" : "=r"(dfr0));
    return ((u32)((dfr0 >> 12) & 0xf)) + 1;
}

static inline u32 khwbp_num_wrps(void) {
    u64 dfr0;
    asm volatile("mrs %0, id_aa64dfr0_el1" : "=r"(dfr0));
    return ((u32)((dfr0 >> 20) & 0xf)) + 1;
}
指令断点控制位按 EL0 匹配来填:
#define DBG_CR_E        (1u << 0)
#define DBG_CR_PRIV_EL0 (0b10u << 1)
#define DBG_CR_SSC_NS   (0b00u << 14)
#define DBG_CR_BAS(mask) (((u32)(mask) & 0xff) << 5)

static inline void khwbp_calc_bp(u64 addr, u64 *out_val, u32 *out_ctrl) {
    *out_val  = addr & ~0x3ULL;
    *out_ctrl = DBG_CR_E | DBG_CR_PRIV_EL0 | DBG_CR_SSC_NS | DBG_CR_BAS(0xf);
}
写寄存器不能用变量拼名字,DBGBVR0_EL1 到 DBGBVR15_EL1 必须展开成 switch:
#define KHWBP_WR_CASE(n, reg) \
    case n: asm volatile("msr " #reg #n "_el1, %0" :: "r"(val)); break

static inline void dbg_write_reg(enum dbg_reg_file file, int n, u64 val) {
    switch (file) {
    case DBG_REG_BVR:
        switch (n) { KHWBP_WR_CASE(0, dbgbvr); KHWBP_WR_CASE(1, dbgbvr); /* ... */ }
        break;
    case DBG_REG_BCR:
        switch (n) { KHWBP_WR_CASE(0, dbgbcr); KHWBP_WR_CASE(1, dbgbcr); /* ... */ }
        break;
    }
    asm volatile("isb" ::: "memory");
}
更新 slot 后同步所有 CPU:
static void hwbp_apply_cpu(void *unused) {
    khwbp_unlock_os_lock();

    for (int i = 0; i < n_brps; i++)
        dbg_write_reg(DBG_REG_BCR, i, 0);

    for (int i = 0, bp = 0; i < KHWBP_MAX_SLOTS; i++) {
        struct slot *s = &slots[i];
        if (!s->used || s->kind != KHWBP_KIND_EXEC)
            continue;
        dbg_write_reg(DBG_REG_BVR, bp, s->val);
        dbg_write_reg(DBG_REG_BCR, bp, s->ctrl);
        bp++;
    }

    write_mdscr(read_mdscr() | MDSCR_EL1_MDE | MDSCR_EL1_KDE);
}
3.2 接管 do_debug_exception
APatch / KernelPatch KPM 不能静态链接内核符号,初始化时用 kallsyms_lookup_name 找需要的函数:
R(printk, "printk", "_printk");
R(on_each_cpu, "on_each_cpu");
R(do_debug_exception, "do_debug_exception");
R(migrate_disable, "migrate_disable");
R(migrate_enable, "migrate_enable");
R(send_sig, "send_sig");
hook 入口里拿到 far/esr/regs,按 ESR 的 DBG_ESR_EVT 区分事件:
int hwbp_handle_debug(u64 far, u64 esr, struct pt_regs_min *regs) {
    u32 evt = (u32)((esr >> 27) & 0x7);

    if (evt == 0x1) {
        // software step 完成,复原断点
    }

    if (evt == 0x0) {
        // instruction breakpoint,匹配 PC
    } else if (evt == 0x2) {
        // watchpoint,匹配 FAR
    }
}
这里有一个坑:我们绕过了 perf/hw_breakpoint,原内核并不知道这些 Debug 异常是谁的。如果命中了我们的寄存器却返回给原 handler,轻则 SIGTRAP,重则内核把它当 spurious debug exception 处理。所以只要确认是自己的事件,就必须完整消费。
3.3 踏过断点:从软件单步改成 PC+4 临时断点
命中后最容易踩的坑是:怎么继续执行而不死循环?
第一版走经典方案:禁用当前断点,打开 MDSCR_EL1.SS + PSTATE.SS,单步执行一条后复原。watchpoint 用这个方案没问题;但 exec 断点在部分 Android 内核上会出现 PSTATE/debug mask 组合微妙、单步事件不稳定、head 疯涨、app 卡住等问题。
最终 exec 断点改成更稳的方案:把当前硬件断点临时改到 PC+4。
流程:
- 入口
PC命中; - 不关 slot,只把当前 CPU 的
DBGBVR[n]改成PC+4; - 异常返回后目标线程执行原指令;
- 执行到下一条
PC+4再命中一次; - 在这次“临时命中”里把
DBGBVR[n]改回原地址。
核心代码:
static int step_over_exec_next(int matched, struct slot *s,
                               struct pt_regs_min *regs) {
    int hw = slot_hw_index(matched);
    u64 next_pc = (regs->pc & ~0x3ULL) + 4;

    if (kfn.migrate_disable)
        kfn.migrate_disable();

    if (!step_claim(khwbp_current(), matched, 1, next_pc))
        return 1;

    dbg_write_reg(DBG_REG_BVR, hw, next_pc);
    dbg_write_reg(DBG_REG_BCR, hw, s->ctrl);
    stat_temp_arm++;
    return 0;
}
临时命中时复原:
if (evt == 0x0) {
    struct step_ent *te = step_find(task);
    if (te && te->temp_exec && ((regs->pc & ~3ULL) == (te->pc & ~3ULL))) {
        struct slot *ts = &slots[te->slot];
        int hw = slot_hw_index(te->slot);
        dbg_write_reg(DBG_REG_BVR, hw, ts->val);
        dbg_write_reg(DBG_REG_BCR, hw, ts->ctrl);
        step_release(te);
        migrate_enable();
        return 1;
    }
}
dump 里健康状态应该类似:
stats: bp=75 wp=0 arm=0 ss=0 found=0 miss=0 claimfail=0 temparm=75 temphit=75
也就是 exec 断点不再依赖软件单步,temparm 和 temphit 基本成对。
3.4 pid 过滤:BTF 不稳就用户态解析
硬件 Debug 寄存器是 CPU 级资源,同一个地址如果别的进程也映射了相同 VA,理论上也会触发。实际要按 pid 过滤。
KPM 在异常里能拿到 current,但 task_struct.pid 偏移随内核版本变化。第一版尝试内核侧解析 BTF;后面发现部分设备上大 BTF blob 通过 control 上传不稳,于是改成:
khwbpctl btf在用户态读取/sys/kernel/btf/vmlinux;- 用户态解析
task_struct.pid偏移; - 通过
pidoff <off>发给 KPM; - KPM 异常里用
*(int *)((char *)current + pid_off)读 pid。
成功输出:
btf: task_struct.pid off=1584 (ok)
这一步很关键。没有 pid 偏移时,断点仍能命中,但 pid= 过滤和按包名追踪会变得不可靠。
四、封装成 APatch KPM + 控制器
用户层和内核层的通信路径如下:
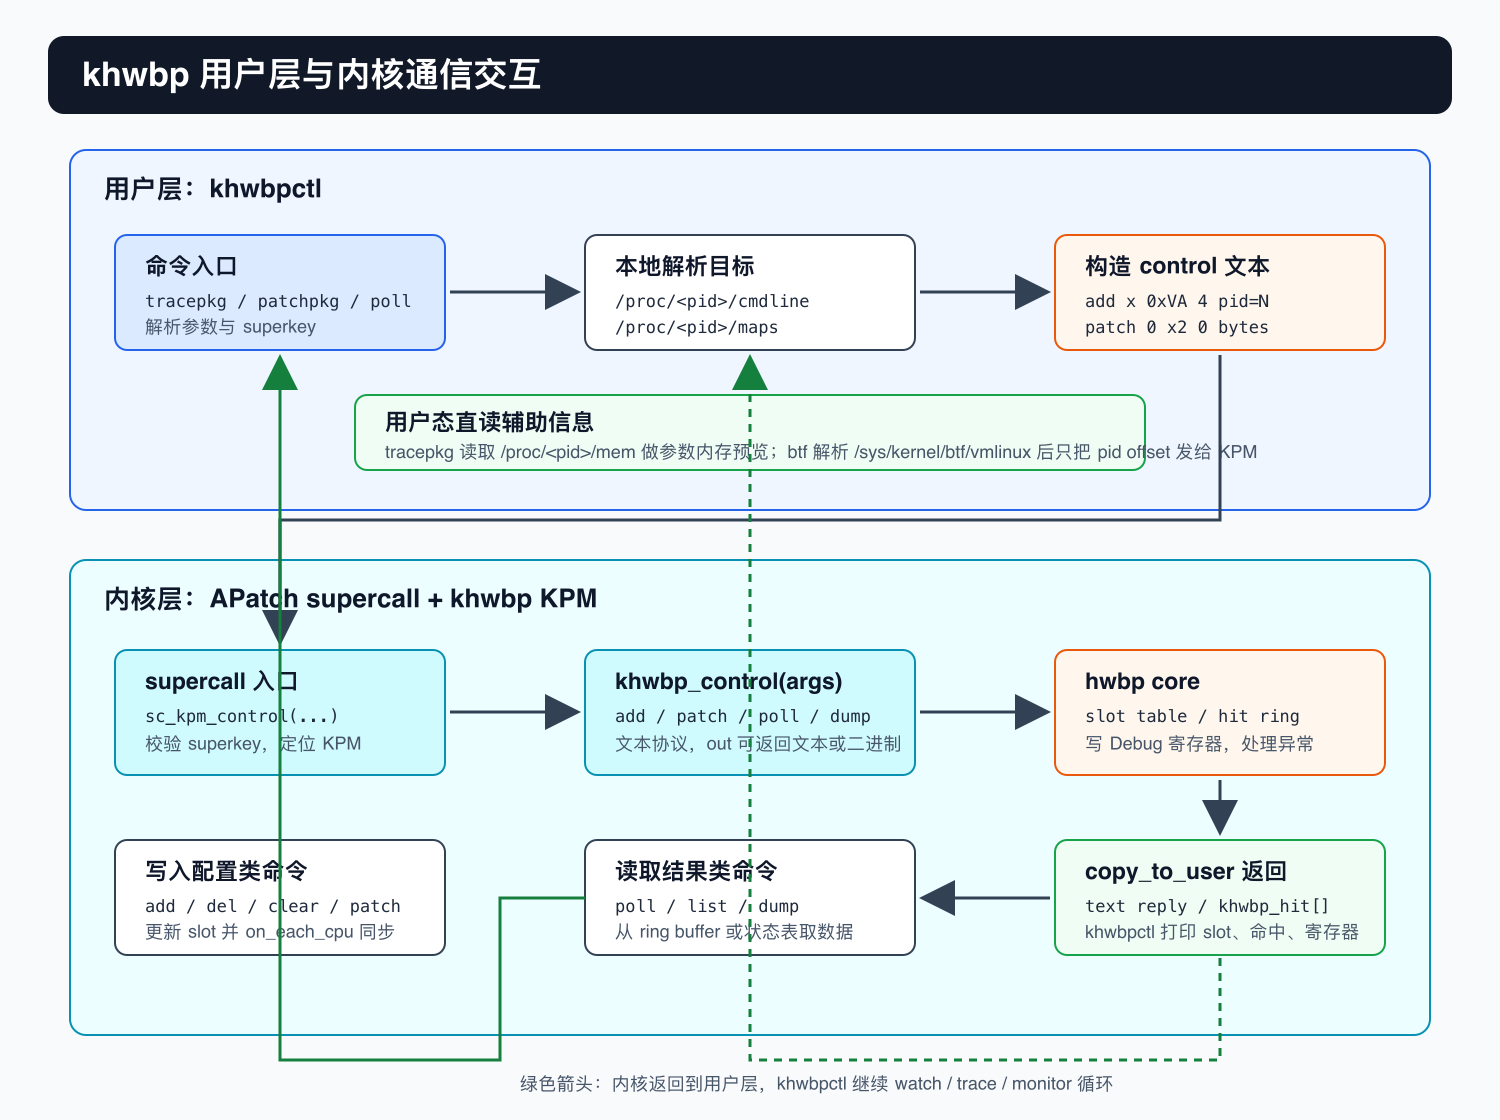
整体分两个产物:
kpm/khwbp.kpm      # APatch / KernelPatch 内核模块
cli/khwbpctl       # Android arm64 静态控制器
构建:
KP_DIR=/path/to/KernelPatch \
NDK=/path/to/android-ndk \
./build.sh
加载:
adb push kpm/khwbp.kpm /sdcard/DCIM/khwbp.kpm
adb push cli/khwbpctl /data/local/tmp/khwbpctl

adb shell
su
cd /data/local/tmp
chmod 755 khwbpctl

/system/bin/truncate <key> module load /sdcard/DCIM/khwbp.kpm
./khwbpctl <key> btf
./khwbpctl <key> selftest
如果 apd 没有 kpm 子命令,直接用 APatch 的 supercall 入口:
/system/bin/truncate <key> module unload khwbp
/system/bin/truncate <key> module load /sdcard/DCIM/khwbp.kpm
4.1 按包名 + SO 文件偏移下断
实战里 IDA 给你的通常是 libxxx.so + file offset,而不是运行时 VA。khwbpctl 会扫 /proc/<pid>/maps:
static int resolve_file_offset(int pid, const char *needle,
                               uint64_t file_off, uint64_t *out_va) {
    // 解析 /proc/<pid>/maps:
    // start-end perms map_off dev inode path
    // 如果 file_off 落在 [map_off, map_off + size),VA = start + file_off - map_off
}
一次性按包名下断:
./khwbpctl <key> addpkg x com.target.app libtarget.so 0x60FF18
App 会重启、pid 会变、ASLR 基址会变,所以更常用的是 watcher:
./khwbpctl <key> watchpkg x com.target.app libtarget.so 0x60FF18
输出类似:
watching x libtarget.so+0x60ff18 for package com.target.app
waiting for package com.target.app...
slot 0
armed package com.target.app -> pid 21397 (com.target.app)
resolved libtarget.so+0x60ff18 -> 0x6e69ba9f18 (.../lib/arm64/libtarget.so)
4.2 tracepkg:参数、返回值、内存预览
tracepkg 是日常分析最舒服的命令:
./khwbpctl <key> tracepkg com.target.app libtarget.so 0x60FF18 0x100
命中入口打印:
== call pc=0x6e69ba9f18 target=0x6e69ba9f18 tid=21397
   x0=0xb40000703b029450 x1=0x000000005d922f68 x2=0x0000007fc5558ab8 x3=0x62
   x4=0x0000000000000000 x5=0xb4000070db032448 x6=0x2cd0 x7=0x5da9b390
   sp=0x0000007fc55589c0 lr=0x0000006ff65a3e34
返回值靠临时给 LR 再下一个 exec 断点,并用 LR + SP 配对入口:
== ret  pc=0x6ff65a3e34 target=0x6ff65a3e34 tid=21397 call_sp=0x0000007fc5558f40 x0=0x0
   call x0=0xb40000703b029450 x1=0x000000005d922f68 x2=0x0000007fc5559038 x3=0x0
如果参数像指针,还会从 /proc/<pid>/mem 读一段预览:
mem x2=0x0000007fc5559038 len=256
  0000: 50 e9 c5 f6 6f 00 00 00 ... |P...o...|
这样不需要 Frida、不需要注入 JavaScript,就能先把函数形态、参数角色、返回值行为摸清楚。
4.3 命中后自动改数据
观察只是第一步,有时还需要“命中后改一个参数 / 改一个结构体字段,然后继续执行”。这也是硬件断点 hook 最像 hook 的地方。
KPM slot 上可以挂一个 patch action:
struct slot {
    int patch_enabled;
    int patch_base_reg;   // 0..30=x0..x30, 31=sp, -1=abs, -2=far
    u64 patch_off;
    u32 patch_len;
    u8  patch_bytes[32];
};
命中后在异常处理里计算目标地址并写用户态内存:
static int apply_patch_action(struct slot *s, u64 far,
                              struct pt_regs_min *regs) {
    u64 base, dst;

    if (s->patch_base_reg >= 0 && s->patch_base_reg <= 30)
        base = regs->regs[s->patch_base_reg];
    else if (s->patch_base_reg == 31)
        base = regs->sp;
    else if (s->patch_base_reg == -2)
        base = far;
    else
        base = 0;

    dst = untag_user_ptr(base + s->patch_off);
    return kfn.copy_to_user((void *)dst, s->patch_bytes, s->patch_len);
}
命令:
# 命中 libtarget.so+0x60FF18 时,把 x2 指向内存前 4 字节改成 01 02 03 04
./khwbpctl <key> watchpatchpkg com.target.app libtarget.so 0x60FF18 x2 0 01020304

# 命中时写 x0+0x10,小端写入 0x12345678
./khwbpctl <key> watchpatchpkg com.target.app libtarget.so 0x60FF18 x0 0x10 78563412

# 命中时写固定地址
./khwbpctl <key> watchpatchpkg com.target.app libtarget.so 0x60FF18 abs 0x7fc5558ab8 01000000
dump 看写入是否成功:
patchok=12 patchfail=0 patch_addr=0x7fc5558ab8
这类写法适合改堆、栈、参数指针、返回结构体字段。写只读代码页不一定成功,因为 copy_to_user 仍然尊重页权限;要改代码段,最好提前通过 /proc/<pid>/mem 或别的方式处理映射权限。
五、实战:追踪某加固 App 的 native 风控函数
5.1 选目标
IDA 里定位到目标 so 的一个 native 函数,偏移记为 libtarget.so+0x60FF18。这个函数在设备信息采集链路里被频繁调用,入口参数里有几类东西:
x0/x1:疑似上下文对象或输入 buffer;x2:栈上/堆上的输出结构指针;x3:长度、类型或状态值;lr:调用点稳定,可以顺手追返回值。
函数体做了控制流混淆和大量内联逻辑,但我们只在入口和返回地址看寄存器,不需要理解每个 basic block。
先加载模块并初始化:
/system/bin/truncate <key> module load /sdcard/DCIM/khwbp.kpm
./khwbpctl <key> btf
./khwbpctl <key> selftest
5.2 入口 + 返回追踪
启动追踪:
./khwbpctl <key> tracepkg com.target.app libtarget.so 0x60FF18 0x100
命中后能看到入口参数:
== call pc=0x6e69ba9f18 target=0x6e69ba9f18 tid=21397
   x0=0xb40000703b029450 x1=0x000000005d922f68 x2=0x0000007fc5558ab8 x3=0x62
   x4=0x0000000000000000 x5=0xb4000070db032448 x6=0x2cd0 x7=0x5da9b390
   sp=0x0000007fc55589c0 lr=0x0000006ff65a3e34
   mem x2=0x0000007fc5558ab8 len=256
     0000: 00 00 00 00 90 24 03 db 70 00 00 b4 ... |.....$..p...|
返回时:
== ret  pc=0x6ff65a3e34 target=0x6ff65a3e34 tid=21397 call_sp=0x0000007fc5558f40 x0=0x0
   call x0=0xb40000703b029450 x1=0x000000005d922f68 x2=0x0000007fc5559038 x3=0x0
   mem call.x2=0x0000007fc5559038 len=256
     0000: 01 00 00 00 40 00 00 00 ... |....@...|
这里有两个实战判断:
ret x0=0不一定代表失败,很多 native 函数返回状态码,真正输出写在x2指向的结构里;- TBI tag 要去掉,
0xb4000070...这种指针读内存时要按低 56 位地址处理。
5.3 命中后改字段
确认 x2 是输出结构后,就可以在入口命中时先把某个字段改掉,让原函数继续跑:
./khwbpctl <key> watchpatchpkg com.target.app libtarget.so 0x60FF18 x2 0x10 01000000
检查状态:
./khwbpctl <key> list
./khwbpctl <key> dump
输出类似:
slot 0 exec @0x6e69ba9f18 len=4 pid=21397 patch=x2+0x10:01000000
stats: bp=28 ... temparm=28 temphit=28 patchok=28 patchfail=0 patch_addr=0x7fc5559048
这样就实现了一个很实用的效果:不改函数头、不插 trampoline,函数每次执行到入口时自动改参数/结构体字段,然后继续执行。
六、坑与优化
这套东西能跑起来不难,长期挂在真实 App 上才会露出问题。几个坑都比较硬。
6.1 APatch CLI 不支持 apd kpm
有些设备上:
/data/adb/ap/bin/apd kpm load ...
error: unrecognized subcommand 'kpm'
直接用 supercall:
/system/bin/truncate <key> module load /sdcard/DCIM/khwbp.kpm
/system/bin/truncate <key> module unload khwbp
注意别把 key 写成空变量,否则会变成系统自带 truncate 的普通参数解析,报:
truncate: Needs -s
6.2 btf: err:大 BTF 不适合直接塞 control
早期让 KPM 从 control 通道拿 BTF blob,部分机器直接失败。后面改成用户态解析 /sys/kernel/btf/vmlinux,只把 task_struct.pid 偏移发给内核:
./khwbpctl <key> btf
成功:
btf: task_struct.pid off=1584 (ok)
这比在内核里吞几 MB BTF 稳很多。
6.3 exec 断点不要迷信软件单步
理论上“禁用断点 + 单步 + 复原”最正统,但实测某些 Android 内核组合下 exec 断点会卡在单步恢复。症状:
head 疯涨
hookstat consumed 很高
last_pc 一直是目标 PC
App 卡住
改成 PC+4 临时断点后,健康状态变成:
temparm=N temphit=N ss=0
这个方案对固定 4 字节 AArch64 指令非常顺手。
6.4 TID 和 PID 不是一回事
异常发生在线程上,记录到的 pid 字段实际更接近当前 task 的 pid/tid。目标 App 主进程 pid 和工作线程 tid 不一定相同。早期用户态错误地用 h->pid != pid 过滤,导致明明命中了 ring buffer,却 tracepkg 不打印。
修复方式:KPM 里 pid 过滤只用于确认进程归属;用户态 trace 不再把线程 tid 当主 pid 强过滤。
6.5 返回值追踪会吃硬件槽
tracepkg 为了抓返回值,会在入口命中后给 LR 再下一个临时 exec 断点。设备如果只有 6 个 breakpoint,入口占 1 个,返回地址再占若干个;并发调用太多时,部分返回值可能会跳过,但入口参数仍然可靠。
6.6 命中后写数据只适合用户态可写页
watchpatchpkg 在异常处理里用 copy_to_user 写目标进程地址。它适合:
- 改
x0/x1/x2指向的 buffer; - 改栈上参数;
- 改输出结构字段;
- 改返回结构里的 flag。
但它不适合直接写只读代码页。写代码段如果页权限不允许,patchfail 会涨。这个限制反而是好事:异常上下文里少做危险操作,稳定性比“什么都能写”更重要。
七、总结
| inline hook / Frida | Android KPM 硬件断点 hook | |
|---|---|---|
| 改目标代码 | ✅ 通常要改函数头或插 trampoline | ❌ 不改目标指令 |
| 过代码完整性 | ❌ 容易被 CRC/hash 发现 | ✅ 目标 text 不变 |
| 注入特征 | 明显,maps/线程/符号都可能暴露 | 控制面在 KPM,用户态痕迹少 |
| 数量限制 | 基本无限 | 硬件槽很少,常见 6 个 exec |
| 核心机制 | inline patch / JS runtime / PLT/GOT | DBG* 寄存器 + do_debug_exception |
| 额外能力 | 成熟生态,脚本方便 | 可在命中异常里读寄存器、改用户态数据 |
硬件断点 hook 不是 Frida/Dobby 的替代品,而是一个很适合“安静观察”的补充工具:当目标做了代码完整性校验、反 inline hook、反注入,或者你只想在关键 native 函数入口拿一眼参数,它非常好用。
Android 这条路比较硬:要进 KPM、写 Debug 寄存器、接管 do_debug_exception,还得自己处理 pid 过滤、单步恢复、App 重启重挂。但一旦跑通,收益也很直接:目标 App 代码一字节不动,入口参数、返回值、内存预览、命中后改数据都能做。
实战里,khwbp 已经能完成一条完整链路:
/system/bin/truncate <key> module load /sdcard/DCIM/khwbp.kpm
./khwbpctl <key> btf
./khwbpctl <key> tracepkg com.target.app libtarget.so 0x60FF18 0x100
./khwbpctl <key> watchpatchpkg com.target.app libtarget.so 0x60FF18 x2 0x10 01000000
剩下可以继续优化的方向也很明确:多 slot 调度、按调用栈过滤、返回点批量复用、watchpoint 的读写条件细化,以及把命中日志输出成更适合 IDA/Ghidra 对照的格式。
本文涉及的逆向均在自有设备、用于安全研究与对抗学习,请勿用于非法用途。
文档信息
- 本文作者:我是小三
- 本文链接:https://xiaosan-re.github.io/2026/07/02/android-hardware-breakpoint-hook/
- 版权声明:自由转载-非商用-非衍生-保持署名(创意共享3.0许可证)