一、背景 & 场景
1.1 环境
设备型号:iPhone 14、iOS 版本:16.x、越狱方案:Dopamine(rootless,/var/jb)
工具链:Theos、IDA Pro 9.2、ellekit
1.2 引言
做 iOS 逆向,hook 是绕不开的基本功。主流方案——Substrate / Dobby / fishhook——本质都是 inline hook:改写目标函数开头几条指令,跳到自己的 trampoline。这套在大多数场景够用,但碰到带完整性校验的目标就难受了:
- 改了
__text段,App 自己做的 CRC / 段哈希一算就对不上; - iOS 的 W^X 和代码签名让”把跳板写进代码段”本身就要折腾
MAP_JIT; - 函数头的
B/LDR PC跳板有明显特征,反 hook 扫描一眼就能发现。
有没有一种 hook 完全不碰目标内存?有——硬件断点。它是 CPU 里专门的地址比较器,命中后产生调试异常,全程不改一个字节的指令。代价是数量有限(arm64 通常 6 个指令断点)、且强依赖异常机制。
本文从 lldb debugserver 的寄存器填法出发,自己撸一套 iOS arm64(e) 进程内硬件断点 hook 框架,封装成越狱插件,最后实战 hook 某加固 App 的设备信息加密函数,抓出明文 JSON 和每次调用的密钥。(文中目标 App 名、专有符号、采集到的指纹/密钥/明文等均已脱敏。)
1.3 对抗场景:安全 SDK 的 hook 检测
直接的动机来自实战:目标 App 集成了一套商业安全 SDK(做设备风控 / 反作弊),它自带 hook 检测。一旦发现自己被 hook,轻则在上报里打一个”环境异常”标记把你拉黑,重则直接返回脏数据、让你逆出来的算法对不上。常见的检测手段有:
- 代码完整性校验:对自己的
__text段做 CRC / 哈希,inline hook 改了开头几条指令 → 校验失败; - 函数序言扫描:检查关键函数开头是不是
B/LDR PC/BR Xn这类跳板特征; - Frida / 注入特征:扫
frida-gum、gadget、可疑DYLD_INSERT_LIBRARIES、异常的内存可执行区、监听端口等; - 符号/IMP 校验:对比 ObjC method 的 IMP 是否指向自己模块之外(抓 method swizzle)。
可以看到,这些检测全部针对”代码/内存被改”或”有外来注入特征”。于是思路很自然:
用一种完全不改目标代码、不留 trampoline、不依赖 Frida 的 hook,绕过上面所有针对”改内存 / 注入特征”的检测——这正是硬件断点的主场。它的命中靠 CPU 寄存器比较,目标的指令、method 表一个字节都不动,前 4 类检测全部失效。残留的检测面只剩”调试寄存器是否被设置”和”异常端口是否被占”,对抗收敛到这两点(见第六节)。
1.4 研究动机与目标
- 搞清楚 iOS 上硬件断点到底怎么落到寄存器、怎么经内核分发到用户态;
- 自己实现一套无痕 hook,绕过安全 SDK 针对 inline-hook / 注入特征的检测;
- 在真实加固 App(带反插桩与 hook 检测的商业安全 SDK)上验证可用性与稳定性。
二、硬件断点原理
2.1 三层机制
iOS(arm64)上的硬件断点,本质是 ARMv8 Debug 架构的断点寄存器 + XNU 把它封装成 thread state + Mach 异常。分三层:
① 底层:CoreSight / ARMv8 调试寄存器
硬件断点不是软件断点那种改指令写 BRK,而是 CPU 里专门的比较器:
- 指令断点:
DBGBVR<n>_EL1(存地址)+DBGBCR<n>_EL1(控制/使能) - 数据观察点:
DBGWVR<n>_EL1+DBGWCR<n>_EL1
数量由 ID_AA64DFR0_EL1 报告,苹果 A 系列大核典型是 6 个指令断点 + 4 个观察点。命中后 CPU 产生一个同步 Debug 异常。
DBGBCR 关键位:
| 位 | 名称 | 含义 |
|---|---|---|
| bit0 | E | 使能 |
| bits[2:1] | PMC | 特权级匹配,EL0(用户态)填 0b10 |
| bits[8:5] | BAS | Byte Address Select,AArch64 下填 0b1111 |
② 内核层:XNU 不让用户态直接写 EL1 寄存器
这些是 EL1 特权寄存器,App(EL0)不能直接 MSR。XNU 用 arm_debug_state64_t 做中转:
struct arm_debug_state64 {
    __uint64_t bvr[16];   // 断点地址
    __uint32_t bcr[16];   // 断点控制
    __uint64_t wvr[16];   // 观察点地址
    __uint32_t wcr[16];   // 观察点控制
    __uint64_t mdscr_el1; // 单步等
};
通过 thread_set_state(thread, ARM_DEBUG_STATE64, ...) 写进去,线程被调度回 CPU 时内核把这些值真正 load 进 DBGBVR/DBGBCR。
③ 异常分发:走 Mach 异常,不是信号
这是 iOS 和 Linux 最大的区别。命中后 XNU 把 Debug 异常转成 Mach 异常 EXC_BREAKPOINT,投递给注册的异常端口:
thread_set_exception_ports(thread, EXC_MASK_BREAKPOINT, exc_port,
        EXCEPTION_STATE_IDENTITY | MACH_EXCEPTION_CODES, ARM_THREAD_STATE64);
ptrace 在 iOS 上残废,真正的调试控制全靠 Mach 异常 + thread state。所以硬件断点完全不经过 ptrace。
2.2 为什么叫”无痕”
- 目标代码段一个字节都不改 → 过
__textCRC、段哈希、代码签名、W^X; - 不依赖 trampoline → 没有可被扫描的
B/LDR PC跳板特征; - 检测面只剩两个:调试寄存器本身(对方读
bcr能发现非零)和异常端口被占(thread_get_exception_ports能看到)。对抗就发生在这两点。
三、引擎实现
整体流程分注入期(把断点和异常处理铺好)和运行期(命中后处理并踏过断点)两段,全程不改目标一个字节的指令:
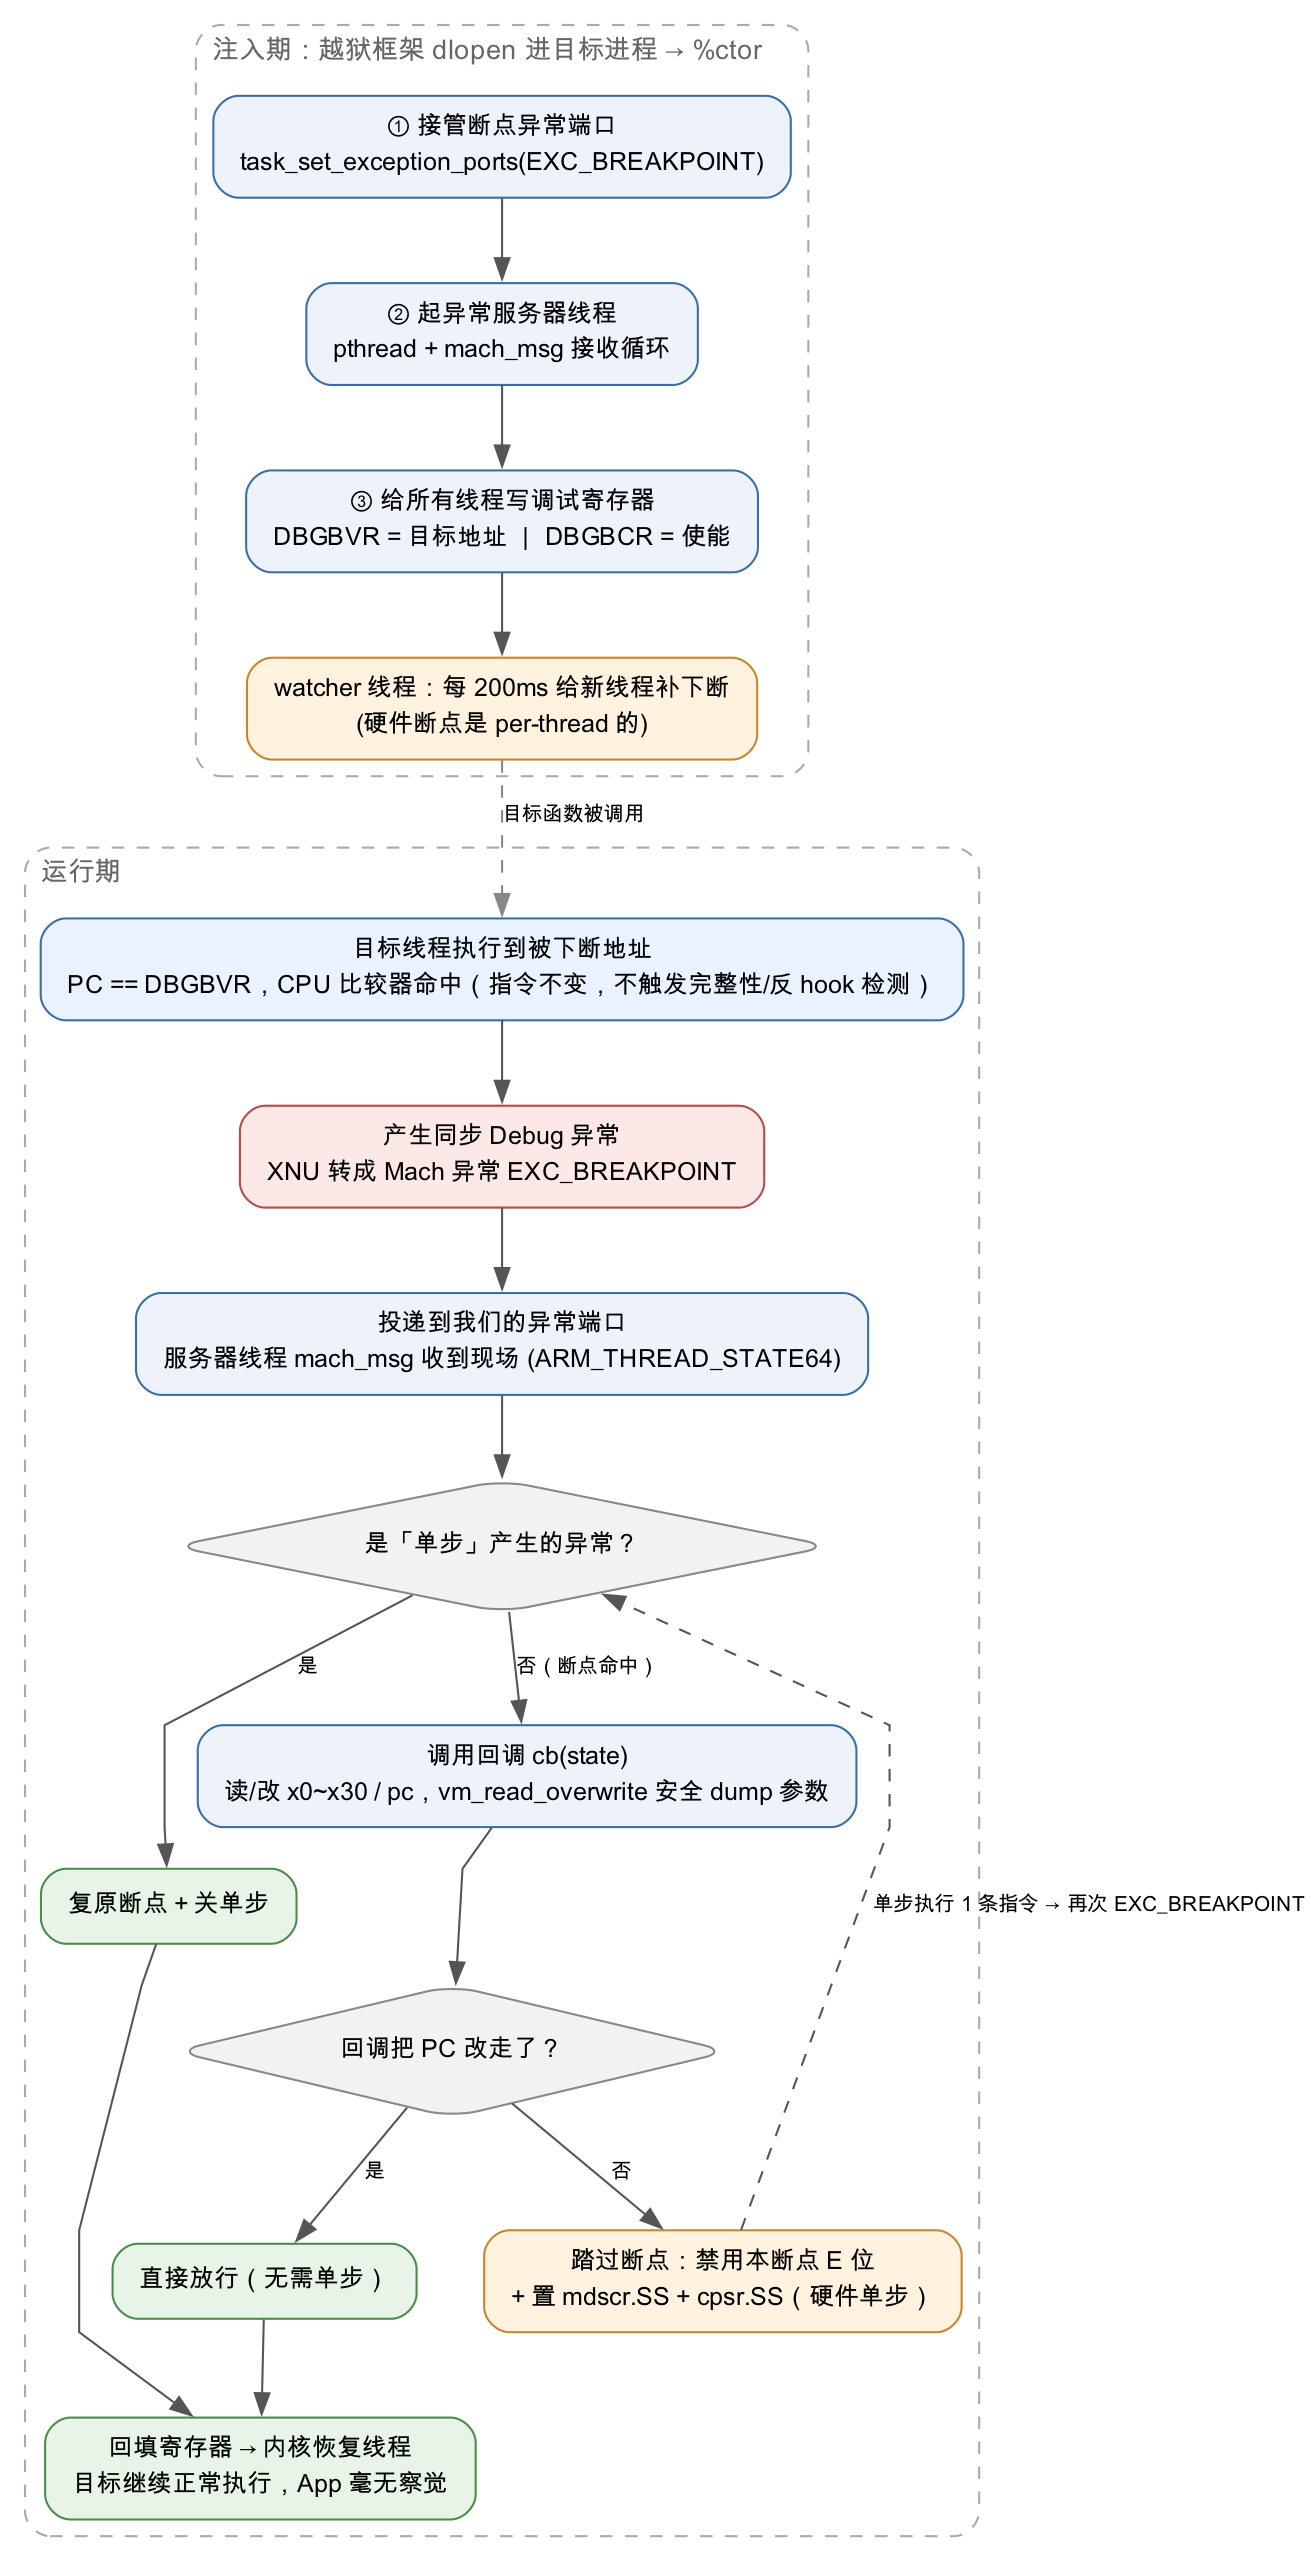
文字版同样的流程:
═══════════════ 注入期 (越狱框架 dlopen 进目标进程 → %ctor) ═══════════════

  ① task_set_exception_ports(EXC_MASK_BREAKPOINT, 我们的端口)   接管断点异常
  ② pthread_create ─► 异常服务器线程 (跑 mach_msg 接收循环)
  ③ 对所有线程 thread_set_state(ARM_DEBUG_STATE64):
        DBGBVR[n] = 目标函数地址 (strip PAC, 4字节对齐)
        DBGBCR[n] = BAS | PMC_EL0 | ENABLE
     + watcher 线程: 每 200ms 给「新出现的线程」补下断 (硬件断点 per-thread)

═══════════════════════════ 运行期 ═══════════════════════════

   目标线程执行到被下断的地址:  PC == DBGBVR[n]
            │  CPU 地址比较器命中 (指令不变,不触发任何完整性/反hook检测)
            ▼
     产生同步 Debug 异常  ──►  XNU 转成 Mach 异常 EXC_BREAKPOINT
            │  (目标线程挂起,等待异常处理回复)         │
            │                                          ▼
            │                          投递到我们注册的异常端口
            ▼                                          │
   ┌──────────────────────── 异常服务器线程 ────────────────────────┐
   │  mach_msg 收到消息 (携带 ARM_THREAD_STATE64 即寄存器现场)       │
   │     │                                                          │
   │     ├─ 这是「单步」产生的异常? ─是─► 复原断点 + 关单步 ──┐     │
   │     │                                                    │     │
   │     └─ 否,是断点命中                                      │     │
   │          │                                               │     │
   │          ▼  调用回调 cb(state): 读/改 x0~x30 / pc / sp    │     │
   │          │     (vm_read_overwrite 安全 dump 参数,不崩)    │     │
   │          ▼                                               │     │
   │      回调把 PC 改走了? ─是─► 直接放行 (无需单步) ────────┤     │
   │          │ 否                                            │     │
   │          ▼  踏过断点: 禁用本断点 E 位 + 置 mdscr.SS+cpsr.SS│     │
   └──────────│──────────────────────────────────────────────│─────┘
              │  把(可能改过的)寄存器回填 new_state            │
              ▼  内核据此恢复目标线程                          │
   目标线程单步执行命中处那一条指令 ──► 再次触发 EXC_BREAKPOINT │
              │                                                │
              └────────────────────────────────────────────────┘
                     (回到服务器,走上面「单步异常」分支:复原断点、关单步)
              │
              ▼
        目标线程继续正常执行,App 毫无察觉
寄存器位怎么填、单步怎么搞,参考 lldb 的 DNBArchImplARM64.cpp(EnableHardwareBreakpoint / 单步逻辑)。
3.1 下断点
// arm64 调试架构常量(参考 lldb DNBArchImplARM64)
#define BCR_ENABLE   (1u << 0)        // E:  使能
#define BCR_PMC_EL0  (0b10u << 1)     // PMC: 在 EL0(用户态)匹配
#define BCR_BAS_ALL  (0b1111u << 5)   // BAS: AArch64 下全 4 字节
#define MDSCR_SS     (1u << 0)        // MDSCR_EL1.SS: 软件单步使能
#define PSTATE_SS    (1u << 21)       // CPSR/PSTATE.SS

static void apply_bps_to_thread(mach_port_t th) {
    arm_debug_state64_t d;
    mach_msg_type_number_t c = ARM_DEBUG_STATE64_COUNT;
    thread_get_state(th, ARM_DEBUG_STATE64, (thread_state_t)&d, &c);
    for (int i = 0; i < MAX_HW_BP; i++) {
        if (g_bps[i].used) {
            d.__bvr[i] = g_bps[i].addr & ~3ULL;            // 4 字节对齐
            d.__bcr[i] = BCR_BAS_ALL | BCR_PMC_EL0 | BCR_ENABLE;
        }
    }
    thread_set_state(th, ARM_DEBUG_STATE64, (thread_state_t)&d, ARM_DEBUG_STATE64_COUNT);
}
注意 arm64e 上函数指针带 PAC,下断前要
ptrauth_strip:static uint64_t strip_pac(uint64_t p) { #if __has_feature(ptrauth_calls) return (uint64_t)ptrauth_strip((void *)p, ptrauth_key_function_pointer); #else return p; #endif }
3.2 Mach 异常服务器(手写消息,免 MIG)
注册异常端口,起一个线程跑 mach_msg 接收循环。为了单文件自包含,这里不用 mig,直接手写 mach_exception_raise_state_identity(id=2407)的请求/应答结构:
#pragma pack(4)
typedef struct {
    mach_msg_header_t          Head;
    mach_msg_body_t            msgh_body;
    mach_msg_port_descriptor_t thread;
    mach_msg_port_descriptor_t task;
    NDR_record_t               NDR;
    exception_type_t           exception;
    mach_msg_type_number_t     codeCnt;
    int64_t                    code[2];
    int                        flavor;
    mach_msg_type_number_t     old_stateCnt;
    natural_t                  old_state[THREAD_STATE_MAX];
} exc_request_t;

typedef struct {
    mach_msg_header_t       Head;
    NDR_record_t           NDR;
    kern_return_t          RetCode;
    int                    flavor;
    mach_msg_type_number_t new_stateCnt;
    natural_t              new_state[THREAD_STATE_MAX];
} exc_reply_t;
#pragma pack()
用 EXCEPTION_STATE_IDENTITY,内核会把 thread state 直接放进消息,我们改完 old_state→new_state 内核就用它恢复线程——这是无痕的关键,全程不碰目标内存:
static void *exc_server_thread(void *arg) {
    for (;;) {
        exc_request_t req; exc_reply_t rep;
        memset(&req, 0, sizeof(req));
        mach_msg(&req.Head, MACH_RCV_MSG, 0, sizeof(req),
                 g_exc_port, MACH_MSG_TIMEOUT_NONE, MACH_PORT_NULL);

        mach_port_t thread = req.thread.name;
        arm_thread_state64_t *st = (arm_thread_state64_t *)req.old_state;
        kern_return_t rc = handle_exception(thread, req.exception, st);

        memset(&rep, 0, sizeof(rep));
        rep.Head.msgh_bits = MACH_MSGH_BITS(MACH_MSGH_BITS_REMOTE(req.Head.msgh_bits), 0);
        rep.Head.msgh_remote_port = req.Head.msgh_remote_port;
        rep.Head.msgh_id = req.Head.msgh_id + 100;   // 2407 -> 2507
        rep.NDR = req.NDR; rep.RetCode = rc; rep.flavor = req.flavor;
        if (rc == KERN_SUCCESS) {
            rep.new_stateCnt = req.old_stateCnt;
            memcpy(rep.new_state, req.old_state, req.old_stateCnt * sizeof(natural_t));
            rep.Head.msgh_size = offsetof(exc_reply_t, new_state)
                               + req.old_stateCnt * sizeof(natural_t);
        } else {
            rep.Head.msgh_size = offsetof(exc_reply_t, flavor);
        }
        mach_msg(&rep.Head, MACH_SEND_MSG, rep.Head.msgh_size, 0,
                 MACH_PORT_NULL, MACH_MSG_TIMEOUT_NONE, MACH_PORT_NULL);
        mach_port_deallocate(mach_task_self(), req.thread.name);
        mach_port_deallocate(mach_task_self(), req.task.name);
    }
    return NULL;
}
3.3 踏过断点:本框架最核心的难点
命中后怎么继续执行而不死循环?因为硬件断点还挂在那个地址,异常返回后会立刻再次命中。解法是经典的「禁用断点 + 硬件单步 + 复原」:
- 命中 → 跑用户回调;
- 如果回调没改 PC(还要执行原指令)→ 临时关掉本断点的
bcr.E,同时打开单步(mdscr_el1.SS+cpsr.SS); - CPU 单步执行完命中那条指令后,再产生一个单步异常(也走
EXC_BREAKPOINT); - 在这次异常里把断点重新打开、关掉单步。
static kern_return_t handle_exception(mach_port_t thread, exception_type_t exc,
                                      arm_thread_state64_t *st) {
    if (exc != EXC_BREAKPOINT) return KERN_FAILURE;

    uint64_t tid = tid_of(thread);
    pthread_mutex_lock(&g_lock);
    step_ctx_t *sc = step_get(tid);

    // 情况 1:这是我们刚才发起的「单步」产生的异常 —— 复原断点,关单步,放行
    if (sc && sc->slot >= 0) {
        arm_debug_state64_t d;
        if (get_dbg(thread, &d) == KERN_SUCCESS) {
            d.__bcr[sc->slot] |= BCR_ENABLE;   // 重新挂上之前禁用的断点
            d.__mdscr_el1     &= ~MDSCR_SS;     // 关单步
            set_dbg(thread, &d);
        }
        st->__cpsr &= ~PSTATE_SS;
        sc->slot = -1; sc->tid = 0;            // 释放槽位
        pthread_mutex_unlock(&g_lock);
        return KERN_SUCCESS;
    }

    // 情况 2:断点命中 —— 找到是哪个槽位
    uint64_t pc = strip_pac((uint64_t)arm_thread_state64_get_pc(*st));
    hb_entry_t *hit = NULL;
    for (int i = 0; i < MAX_HW_BP; i++)
        if (g_bps[i].used && (g_bps[i].addr & ~3ULL) == (pc & ~3ULL)) { hit = &g_bps[i]; break; }
    if (!hit) { pthread_mutex_unlock(&g_lock); return KERN_FAILURE; } // 不是我们的,转发出去

    hb_callback_t cb = hit->cb; void *user = hit->user; int slot = hit->slot;
    pthread_mutex_unlock(&g_lock);

    if (cb) cb(st, user);   // ===== 用户 hook 逻辑 =====

    // 用户改了 PC 就不会再撞断点,直接放行,无需单步
    uint64_t newpc = strip_pac((uint64_t)arm_thread_state64_get_pc(*st));
    if ((newpc & ~3ULL) != (pc & ~3ULL)) return KERN_SUCCESS;

    // PC 没动 —— 必须「踏过去」
    pthread_mutex_lock(&g_lock);
    arm_debug_state64_t d;
    if (get_dbg(thread, &d) == KERN_SUCCESS) {
        d.__bcr[slot] &= ~BCR_ENABLE;
        d.__mdscr_el1 |= MDSCR_SS;
        set_dbg(thread, &d);
    }
    st->__cpsr |= PSTATE_SS;
    step_ctx_t *ns = step_find_or_alloc(tid);
    if (ns) ns->slot = slot;
    pthread_mutex_unlock(&g_lock);
    return KERN_SUCCESS;
}
mdscr_el1.SS和cpsr.SS必须配合置位,arm64 软件单步才真正生效。
3.4 per-thread 难题
这是硬件断点相对 inline hook 最大的弱点:调试寄存器是 per-thread 的。thread_set_state 只对一个线程生效,新建的线程不会自动带上断点。如果目标函数跑在 hook 之后才创建的线程上,永远不命中。
第一版用一次性 hb_install_all_threads()(遍历 task_threads 给所有现存线程下断),但这只覆盖”下断时已存在的线程”。后面会讲怎么用一个后台 watcher 彻底解决。
四、封装成越狱插件
引擎是自包含的 C,不依赖 Substrate。注入交给越狱框架(ellekit)按 bundle id 把 dylib dlopen 进目标进程,%ctor 里起服务器 + 下断。
Tweak.xm 的目标定位支持两种方式:
// 方式 A:hook 某 ObjC 实例方法的 IMP —— 拦方法但不 swizzle,method 表/指令都不动
static const char *TARGET_CLASS = NULL;
static const char *TARGET_SEL   = NULL;

// 方式 B:hook native 函数。IMAGE=mach-o 名后缀, OFFSET = IDA 地址 - IDA image base
static const char *TARGET_IMAGE  = "TargetApp";
static const uint64_t TARGET_OFFSET = 0x9XXXXX;   // 目标函数偏移,按自己 IDA 实测填
运行期基址(含 ASLR slide)这样取:
static uintptr_t image_base_by_suffix(const char *suffix) {
    uint32_t cnt = _dyld_image_count();
    for (uint32_t i = 0; i < cnt; i++) {
        const char *name = _dyld_get_image_name(i);
        size_t nl = strlen(name), sl = strlen(suffix);
        if (nl >= sl && strcmp(name + nl - sl, suffix) == 0)
            return (uintptr_t)_dyld_get_image_header(i);
    }
    return 0;
}
%ctor 里下断 + 开 watcher:
%ctor {
    @autoreleasepool {
        install_hooks();
        hb_enable_thread_watcher();   // 自动给新线程补断点(见第六节)
    }
}
非越狱也能用:把
hbhook.c/.h直接拖进自己的 Xcode 工程,Debug 包自带get-task-allow,进程就有权给自己设异常端口和调试寄存器。适合自调试 / 自保护 / PoC。
五、实战:hook 某加固 App 的设备信息加密
5.1 选目标
IDA 里目标主程序某个 native 函数(命名 getdeviceinfo_sub),被一个形如 +[UIDevice xxx_riskInfoCryptInner:andLength:andGen:andKey:…andAppendData:] 的 ObjC 方法调用——典型的设备信息采集 + 加密内核。函数体是 OLLVM 控制流平坦化(一个取 opcode 的派发循环 + 大量内联 EOR 串解密),但只 hook 入口、不进 VM,完全不受混淆影响。
序言保存的寄存器给出参数布局(地址用相对偏移示意):
func+0x20  MOV  X22, X7        ; x7
func+0x28  STUR X6, [...]      ; x6
func+0x30  STUR W5, [...]      ; w5(32位)
func+0x38  MOV  X20, X3        ; x3
func+0x3C  MOV  X21, X2        ; x2
func+0x44  STUR W1, [...]      ; w1(32位,length)
func+0x4C  STUR X0, [...]      ; x0
5.2 回调:安全读参数
第一版回调直接把参数当 OC 对象 isKindOfClass,结果 EXC_BAD_ACCESS 闪退——@try 抓不住 BAD_ACCESS(那是 Mach 异常不是 NSException)。教训:逆向场景别盲目发消息,用 vm_read_overwrite 安全读,地址非法只返回错误码、绝不崩:
static void dump_mem(const char *tag, uint64_t addr, size_t len) {
    if (!addr) { NSLog(@"  %-8s = (null)", tag); return; }
    if (len == 0) len = 32; if (len > 4096) len = 4096;
    static uint8_t buf[4096]; vm_size_t out = 0;
    kern_return_t kr = vm_read_overwrite(mach_task_self(),
                          (vm_address_t)addr, len, (vm_address_t)buf, &out);
    if (kr != KERN_SUCCESS) {
        NSLog(@"  %-8s @0x%llx 不可读(可能是标量, kr=%d)", tag, (unsigned long long)addr, kr);
        return;
    }
    NSMutableString *h = [NSMutableString string], *a = [NSMutableString string];
    for (vm_size_t i = 0; i < out; i++) {
        [h appendFormat:@"%02x", buf[i]];
        [a appendFormat:@"%c", (buf[i] >= 0x20 && buf[i] < 0x7f) ? buf[i] : '.'];
    }
    NSLog(@"  %-8s @0x%llx (%lu): %@ | %@", tag, (unsigned long long)addr, (unsigned long)out, h, a);
}
5.3 命中结果
触发一次风控操作,命中(注意是后台线程)。以下日志中的指纹、密钥、明文等敏感字节均已脱敏,仅保留结构:
[hbhook] crypt-inner hit  thread=0x16xxxxxxx
  raw x0..x7 = 1xxxxxxxx 100 1xxxxxxxx 2xxxxxxxx 1 3e9 0 0
  w1 len = 256   stk append = 0x2xxxxxxxx
  x0 data @0x1xxxxxxxx (256): 7a65……(256B 高熵,已脱敏)
  x3 obj  @0x2xxxxxxxx (64): 4158bf1b02000003 20000000 00000000
                              ……(紧随 16 字节对象头的 32B 高熵,已脱敏)
  append  @0x2xxxxxxxx: <对象头16B> 357b0a……("xxxxdf" 字段的 UTF8,已脱敏)……
                        | 5{  "xxxxdf" : "AC45****……****C251"\n}
解码三个关键参数:
append= 单字段明文 JSON:对象布局isa(8) + len32 + flags32 + [1字节长度前缀][UTF8],内容形如{"xxxxdf":"AC45****……****C251"}(指纹值已脱敏)。该字段是稳定设备指纹(多次调用不变),这就是上层安全 SDK 加密前的 body 明文。x3= 32 字节 per-call 高熵:两次调用完全不同 → 每次随机的密钥 / nonce / salt,AEAD key 的有力候选(值已脱敏)。x0= 256 字节裸 buffer:每次变,可能是密文输出、keystream 或 RC4-style 256 字节状态。
一个细节:
x0在普通堆是裸 buffer;x3/append在 nano 堆区(0x2xx……)、带 isa 头是 OC/CF 对象。这就是为什么盲目对x0发消息会崩。
至此,用一个不改任何指令的硬件断点,就把加固 App 的设备信息明文和动态密钥抓了出来。
六、坑与优化
把它长期挂在目标 App(线程多、命中频繁)上,暴露出几个会实际咬人的问题:
6.1 单步状态表只增不减 → 跑久了卡死
踏断点的 per-thread 状态用一张小表记录。第一版单步完成只把 slot=-1,没释放线程项,死线程把表占满后 → 分配失败 → 踏不过断点 → 死循环。修复:单步完成时连 key 一起清掉。
6.2 用 Mach 端口名做 key 不可靠
g_step 一开始用 mach_port_t 当 key,但端口名会跨消息回收:入口命中和单步完成是两条独立 Mach 消息,中间端口名被 deallocate 了,一旦不复用,单步那条消息匹配不上 → 该断点永久卡死。正解是用稳定线程 id:
static uint64_t tid_of(mach_port_t th) {
    thread_identifier_info_data_t ii;
    mach_msg_type_number_t c = THREAD_IDENTIFIER_INFO_COUNT;
    if (thread_info(th, THREAD_IDENTIFIER_INFO, (thread_info_t)&ii, &c) == KERN_SUCCESS)
        return ii.thread_id;
    return 0;
}
g_step 改存 tid,端口名就能放心 deallocate。
6.3 per-thread 的终极解法:后台 watcher
用一个后台线程,只给新出现的线程补断点(按 tid 记忆,死线程自动剔除),并每 ~5s 全量重下一次——顺带兜底”被反调试擦寄存器”的情况:
static void *watcher_thread(void *arg) {
    g_watch_tid = tid_of(pthread_mach_thread_np(pthread_self()));
    static uint64_t seen[1024]; static int nseen = 0;
    int tick = 0;
    while (g_watch_run) {
        if (++tick >= 25) { nseen = 0; tick = 0; }   // 每 ~5s 全量重下(兜底)
        thread_act_array_t threads; mach_msg_type_number_t n;
        if (task_threads(mach_task_self(), &threads, &n) == KERN_SUCCESS) {
            uint64_t now[1024]; int nnow = 0;
            pthread_mutex_lock(&g_lock);
            for (unsigned i = 0; i < n; i++) {
                mach_port_t th = threads[i];
                uint64_t tid = tid_of(th);
                if (tid && tid != g_server_tid && tid != g_watch_tid) {
                    if (nnow < 1024) now[nnow++] = tid;
                    bool was = false;
                    for (int k = 0; k < nseen; k++) if (seen[k] == tid) { was = true; break; }
                    step_ctx_t *sc = step_get(tid);
                    if (!was && !(sc && sc->slot >= 0)) apply_bps_to_thread(th);
                }
                mach_port_deallocate(mach_task_self(), th);
            }
            nseen = nnow;
            for (int k = 0; k < nnow; k++) seen[k] = now[k];
            pthread_mutex_unlock(&g_lock);
            vm_deallocate(mach_task_self(), (vm_address_t)threads, n * sizeof(thread_act_t));
        }
        usleep(200 * 1000);
    }
    return NULL;
}
稳态开销从”每秒数百 syscall”降到”基本只在新线程出现时动一下”。
6.4 还没做但要知道的
- 异常端口转发:
task_set_exception_ports会顶掉 App 原来的EXC_BREAKPOINT处理者(crash 上报 SDK、反调试)。要和它们长期共存,得task_get_exception_ports存旧端口,遇到非我方异常时mach_msg转发回去。否则可能互相打架,或者你被对方顶掉(表现为命中突然停止)。 - 只有 6 个断点槽,多 hook 点要复用 + 动态换。
七、总结
| inline hook(Dobby 等) | 硬件断点 hook | |
|---|---|---|
| 改目标内存 | ✅ 改前 N 条指令 | ❌ 一字节不改 |
| 过 CRC / 代码签名 | ❌ 会被挡 | ✅ 无痕 |
| 数量限制 | 无 | 只有 6 个 |
| 依赖 | trampoline + 指令重定位 | arm_debug_state64 + Mach 异常端口 |
| 检测面 | 函数头跳板特征 | 调试寄存器非零、异常端口被占 |
硬件断点 hook 不是 inline hook 的替代品,而是它的补充:当目标做了完整性校验、反 inline-hook,或者你只想安静地观察而不留痕时,它就是趁手的武器。核心三件套——arm_debug_state64 下断、Mach 异常服务器拿 state、单步踏过断点——配齐了就是一套能在真实加固 App 上跑的无痕 hook。
实战里它帮我们用零内存改动,从一个 OLLVM 平坦化的加密函数入口抓出了设备信息明文和动态密钥。剩下的——抓输出密文凑齐 (明文, key, 密文) 三元组定位算法——只需要在返回地址(LR)再下一个断点,留给下一篇。
本文涉及的逆向均在自有设备、用于安全研究与对抗学习,请勿用于非法用途。
文档信息
- 本文作者:我是小三
- 本文链接:https://xiaosan-re.github.io/2026/06/05/ios-hardware-breakpoint-hook/
- 版权声明:自由转载-非商用-非衍生-保持署名(创意共享3.0许可证)